Корпоративная база знаний с AI: как работает RAG и с чего начать
В компании часто есть ответы на типичные рабочие вопросы — в регламентах, инструкциях, каталогах, документации и переписке. Проблема в том, что знания разбросаны, а найти действующую версию документа бывает сложнее, чем спросить коллегу. Корпоративный AI-ассистент может упростить поиск: сотрудник задаёт вопрос обычным языком, система находит нужные материалы и готовит ответ со ссылками.
Один из подходов — RAG (retrieval-augmented generation, генерация с дополнением поиском). Он сочетает поиск по источникам компании с генерацией текста языковой моделью. Это позволяет использовать документы без переобучения модели при каждом изменении инструкции. Однако сам по себе RAG не гарантирует правильный ответ, соблюдение прав или конфиденциальность: это свойства всей системы и процесса управления ею.
Как работает RAG в корпоративной базе знаний
Обычный поиск выдаёт список документов, которые сотруднику нужно открыть и прочитать. В системе с RAG поиск остаётся важной частью процесса, но затем языковая модель формулирует ответ на основе найденного контекста. В исследовательской работе Lewis и соавторов RAG описан как сочетание генеративной модели с внешней непараметрической памятью, которую можно обновлять независимо от модели.
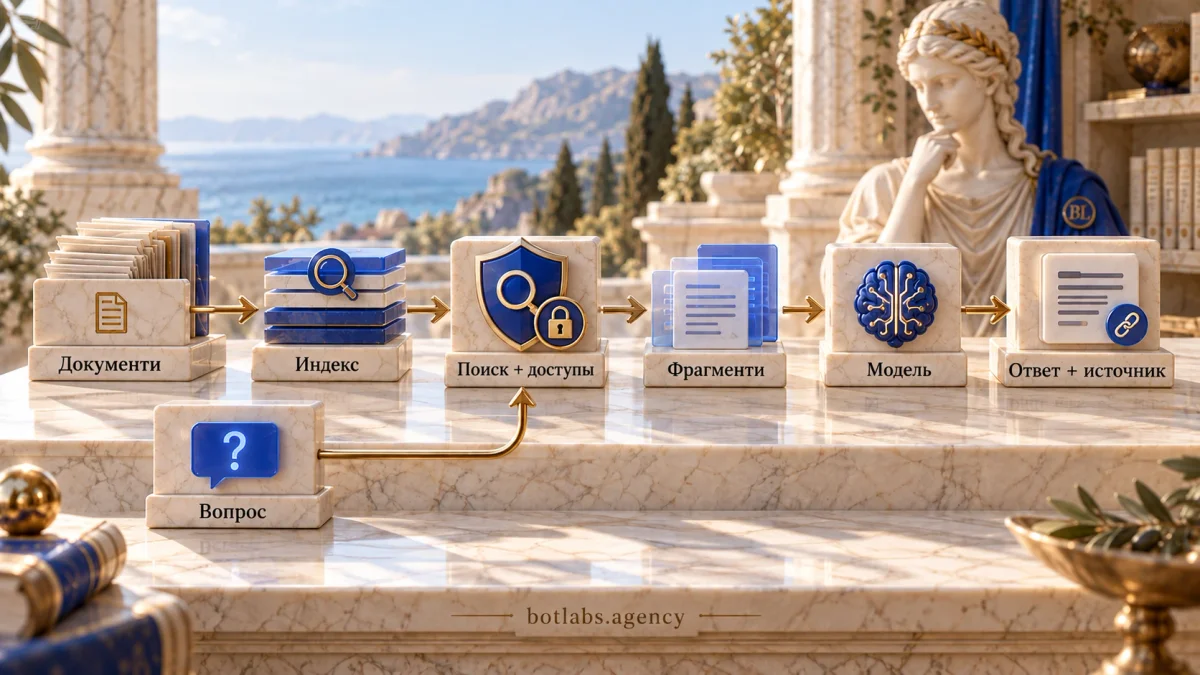
Типовая корпоративная реализация включает несколько этапов:
- Подготовка источников. Документы собирают из разрешённых хранилищ, убирают лишние копии и преобразуют содержимое в формат, пригодный для поиска.
- Индексация. Текст делят на фрагменты, добавляют метаданные — например, название, владельца, дату и уровень доступа — и индексируют.
- Поиск по вопросу. Запрос сотрудника используется для поиска релевантных фрагментов. Права пользователя должны учитываться уже при выдаче результатов.
- Формирование ответа. Модель получает вопрос и найденный контекст, после чего создаёт ответ. Интерфейс может показывать ссылки на источники, чтобы сотрудник мог проверить детали.
Эти этапы не означают, что система всегда найдёт нужное или правильно обобщит материал. Поиск может пропустить важный фрагмент, документы могут противоречить друг другу, а генерация — неверно истолковать контекст. Поэтому ссылки на источники, отказ при недостатке оснований и передача сложного вопроса специалисту должны быть частью проектирования и проверки.
| Подход | Что получает пользователь | Когда стоит рассмотреть |
|---|---|---|
| Поиск по ключевым словам | Список документов или фрагментов | Сотрудники умеют формулировать запросы и готовы читать материалы |
| RAG-ассистент | Сформулированный ответ по найденному контексту и, при корректной реализации, ссылки | Вопросы задают обычным языком, а знания распределены по разным источникам |
| Дообучение модели | Изменённое поведение или формат генерации для определённой задачи | Нужны устойчивые навыки или формат; это не универсальное хранилище меняющихся фактов |
RAG и дообучение решают разные задачи и могут применяться вместе. Внешний источник знаний удобен для часто обновляемых материалов; дообучение может помочь задать поведение или формат. Выбор зависит от данных, качества поиска, требований к приватности, задержки, затрат и поддержки — универсального превосходства одного метода нет.
Какие документы добавлять в базу
Начните с рабочего вопроса, а не с массовой загрузки всех файлов компании. Соберите повторяющиеся запросы сотрудников и определите, какие утверждённые источники уже содержат ответ. Это поможет ограничить первый набор материалов и понять, как оценивать результат.
Для первой версии часто подходят действующие процедуры, инструкции для сотрудников, справки о продукте, правила сервиса, материалы адаптации новичков и внутренние ответы на частые вопросы. Выберите конкретную область знаний: например, правила возврата товара или порядок технической проверки. Не начинайте со всего корпоративного диска, если ещё нет владельцев, классификации доступа и процесса обновления.
Для каждого источника полезно знать:
- кто отвечает за содержание и может подтвердить его актуальность;
- каким ролям предназначен документ;
- дату вступления в силу и следующего пересмотра;
- является ли он официальным источником или справочным материалом;
- с какими другими документами он может конфликтовать.
Устаревший документ не становится правильным оттого, что его нашла AI-система. Определите, как убирать из индекса предыдущие редакции, дубликаты, черновики и файлы без владельца. Если исторические версии нужны для аудита, храните их отдельно и не смешивайте с материалами, по которым ассистент отвечает на текущие вопросы.
Переписка, персональные данные, коммерчески чувствительные материалы и файлы с ограниченным доступом требуют отдельного решения до индексации. Проверьте, разрешено ли использовать их в выбранном сервисе, как обрабатываются журналы запросов и кто может просматривать индекс. Если у источника нет понятной цели или владельца, сначала решите вопрос управления им.
Как обеспечить актуальность и доступ
База знаний — это не разовая загрузка файлов, а процесс управления изменениями. У каждого источника должен быть владелец, отвечающий за содержание, и понятный цикл пересмотра. Когда меняется политика или процедура, обновление должно попасть в поисковый индекс, а прежнюю версию нужно пометить или удалить согласно правилам хранения.
Отдельное требование — права доступа. Если сотрудник не может открыть документ напрямую, AI-ассистент не должен использовать его для ответа этому сотруднику. Microsoft описывает контроль доступа на уровне документов в поиске: идентичность пользователя и ограничения доступа должны учитываться в поисковой выдаче. Реализация зависит от платформы, но общий принцип таков: проверяйте права при получении контекста, а не просите языковую модель угадывать, что можно показать.
Перед запуском проверьте как минимум такие сценарии:
- пользователь видит только документы, разрешённые его роли;
- доступ отзывается при смене роли или увольнении;
- ссылка в ответе не открывает материал более широкой аудитории;
- права одинаково применяются к фрагментам, кэшу, экспорту и журналам;
- удалённые или изменённые документы больше не появляются в результатах;
- ошибки синхронизации заметны ответственной команде.
Применяйте минимально необходимый доступ к хранилищам, индексу и интеграциям. Фиксируйте источник, дату индексации и результат поиска в объёме, нужном для отладки и аудита, но не накапливайте в журналах лишние персональные данные. Определите, кто разбирает ошибочные ответы и как временно отключить проблемный источник или ассистента.
Как уменьшить ошибки и неподходящие ответы
RAG может связать ответ с найденными источниками, но это не гарантирует его точность. Для качества нужны проверенные документы, подходящий поиск, инструкции генерации, понятные ссылки и регулярное тестирование. Ответ без источника или с нерелевантным источником — повод для проверки, а не доказательство надёжности.
Составьте контрольный набор реальных вопросов до запуска. Для каждого зафиксируйте ожидаемые документы, правильные ключевые факты, разрешённую аудиторию и желаемое поведение, если информации недостаточно. Добавьте вопросы, на которые в базе нет ответа, неоднозначные формулировки, конфликтующие версии и запросы от пользователей с разным уровнем доступа. Отдельно оценивайте поиск (найдены ли нужные материалы) и генерацию (корректно ли они переданы в ответе).
Определите правила работы с неопределённостью: когда система отвечает с оговоркой, просит уточнить вопрос, сообщает, что не нашла материал, или передаёт запрос ответственному сотруднику. Не используйте фразу «отвечай только по источникам» как единственный контроль: инструкция не устраняет ошибки поиска и интерпретации. Ссылки в ответах нужно открывать и проверять на понятность, достаточность контекста и соответствие правам пользователя.
В редакции GenAI Top 10 за 2026 год OWASP выделяет в том числе риски, связанные с уязвимостями векторного поиска и embeddings. Для корпоративной базы это означает, что нужно контролировать не только модель, но и источники, добавление содержимого, индексацию, разрешения и реакцию на вредоносные или ошибочные материалы. Используйте список как ориентир анализа угроз, а меры подбирайте с учётом своей архитектуры.
План пилота и метрики
Пилот можно спланировать как короткий цикл, например на 30 дней, если заранее согласованы объём, доступы, источники и команда. Это иллюстративный план, а не обещание, что любую корпоративную базу можно запустить за такой срок. Интеграции, оценка безопасности, очистка документов или закупки могут занять больше времени.
- Определите границы. Выберите одну команду и один тип запросов. Зафиксируйте пользователей, данные и критерии полезного результата.
- Подготовьте корпус. Найдите владельцев документов, подтвердите актуальные версии, обозначьте роли и исключите ненужные или чувствительные материалы.
- Соберите базовую линию. Зафиксируйте типичные вопросы, время поиска ответа и частоту эскалаций в текущем процессе. Подготовьте контрольные вопросы вместе с экспертами.
- Проверьте прототип. Измерьте качество поиска и ответов, проверьте доступы, источники, отказ при недостатке информации и поведение на конфликтных данных.
- Запустите ограниченное использование. Дайте доступ небольшой группе, собирайте оценки «помогло / не помогло» и разбирайте ошибки вместе с владельцами знаний.
- Решите, что дальше. Сравните результаты с базовой линией, оцените риски и затраты, затем исправьте источники, измените границы или остановите пилот.
Измеряйте не только число запросов. Полезны доля ответов, признанных экспертами правильными и достаточными; качество поиска нужного фрагмента; доля ответов с релевантным источником; корректные отказы при отсутствии ответа; успешность проверок доступа; частота эскалаций; время до полезного ответа; стоимость обработки запроса. Сравнивайте показатели на одинаковом наборе сценариев и разделяйте результаты по типу вопроса и роли.
Успешный пилот — не демонстрация нескольких удачных ответов. Команда должна понять, в каких сценариях инструмент помогает, где ошибается, кто поддерживает материалы и приемлемы ли риски и затраты. После этого можно решать, расширять ли аудиторию или добавлять новые источники.
Вывод
Корпоративная AI-база знаний может упростить работу с разбросанными инструкциями, если поиск связан с проверенными источниками, а доступы и обновления управляются вместе с ним. RAG не заменяет качество документов, экспертную проверку или контроль безопасности. Начните с одного конкретного типа вопросов, ограниченного набора действующих источников и заранее заданных критериев качества. Тогда решение о масштабировании будет опираться на работу системы в реальном процессе, а не на впечатление от демонстрации.
Часто задаваемые вопросы
RAG сначала ищет релевантную информацию в подключённых источниках, а затем языковая модель использует найденный контекст для ответа. Ссылки на документы помогают проверить его, если система корректно возвращает источники.
Нет. Поиск может не найти нужный материал, а модель — неверно истолковать найденный фрагмент. Нужны контроль качества документов, тестирование поиска и генерации, понятные ссылки, правила отказа и передача вопроса человеку.
RAG добавляет контекст из внешних источников во время ответа, а дообучение меняет параметры модели для определённого поведения или формата. Это разные инструменты; выбор зависит от того, нужно ли обновлять факты, менять способ ответа или сочетать подходы.
Проверяйте личность пользователя и права в поисковом слое до передачи фрагментов модели. Проверьте также ссылки, кэши, журналы и копии индекса после отзыва доступа.
Срок зависит от состояния документов, интеграций, правил доступа, требований безопасности и объёма тестирования. План на 30 дней может иллюстрировать ограниченный пилот, но не является гарантированным сроком разработки или запуска.
Оценивайте точность поиска и ответа отдельно, релевантность источников, правильность отказов, проверки доступа, время до полезного ответа, эскалации и затраты. Заранее подготовьте реальные вопросы и базовые показатели текущего процесса.
Источники
- Lewis P. и др. Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks (2020).
- Microsoft Learn: Retrieval Augmented Generation (RAG) в Azure AI Foundry.
- Microsoft Learn: обзор управления доступом на уровне документов в Azure AI Search.
- OWASP GenAI Security Project: OWASP Top 10 for LLM Applications 2026.
- Читайте также опубликованные статьи: чат-бот, AI-ассистент или AI-агент · интеграция чат-бота с CRM · выбор между Telegram-ботом и ботом на сайте.
Обсудите AI-базу знаний со специалистом
За 15 минут обсудим источники документов и доступы сотрудников и наметим первую полезную тему для пилота.
С каких знаний
начать пилот?
Обсудим документы и доступы.
Наметим первую тему для команды.